Daha İyi ve Anlamlı Crawl için XPath Kullanımı
 Taha Yelkenci
SEO ve GEO Danışmanı | · güncelleme: | 3 dk okuma
XPath bir HTML belgesindeki öğeleri seçmek için kullanılan sorgu dilidir. Tarama (crawl) tarafında SEO araçlarının özelliklerini karşılaştırdığımda hemen hemen hepsi aynı özellikleri barındırıyor.
Bu ortak özellikler düşük sayfa hızı, duplicate etiketler, title-description-H1 sorunları, link derinliği, yönlendirmeli URL'ler olarak sayılabilir. Daha da uzatabilirim.
Herhangi bir crawl aracı varsayılan ayarlarla kullanıldığında pek efektif sonuçlar alınamayabiliyor.
Düşük otoriteli bir rakibin bile bu şekilde çalışmalar yürüttüğünü düşünürsek, daha fazla veri, daha fazla analiz ve daha fazla anlamlı sonuca ihtiyacımız olacak.
Crawl'ı daha efektif yapabilmek için XPath kullanımından bahsedeceğim. Screaming Frog'un diğer ileri seviye ayarlarını rankZup blogundaki ileri seviye Screaming Frog kullanımı yazısında anlattık.
Screaming Frog ve XPath ile Nasıl Daha Anlamlı Veriler Elde Edilir?
Screaming Frog'da XPath ile daha anlamlı veri, sayfadaki belirli bir öğenin XPath ifadesini Custom Extraction alanına tanımlayıp taramada o öğeyi toplayarak elde edilir.
3 örnek vereyim:
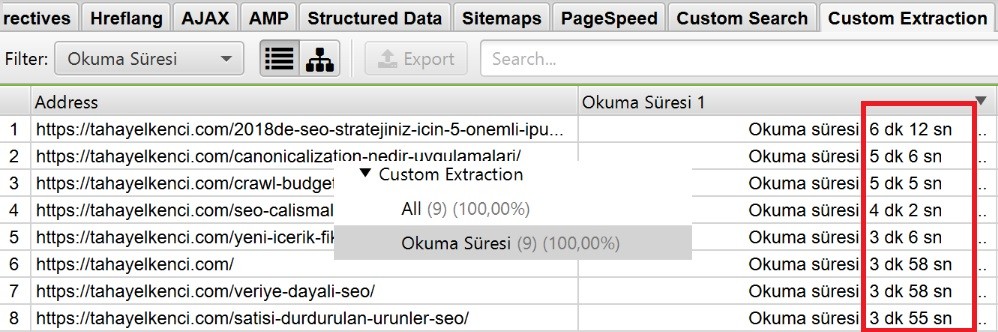
1- Bu blogumda yayınladığım içeriklerin okuma sürelerini toplayabilirim.
Screaming Frog'da XPath kullanımı kısmına geçmek için bu örnekleri atlayabilirsiniz.
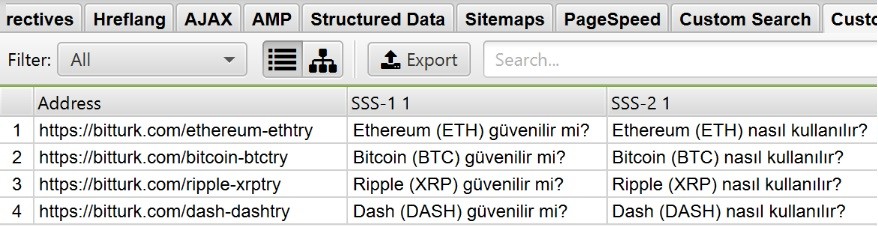
2- Bitturk.com'un ürün sayfalarında bolca sık sorulan sorular (SSS) alanı mevcut. Siteyi crawl ederken tüm SSS sorularını öğrenmek için XPath kullanarak tüm soruları alabiliriz.
3- Elinizdeki bir ürün için açılış sayfası (landing page) hazırlayacağımızı düşünelim.
Bu ürün için kullanıcılar en çok hangi soruları soruyor? En çok memnun kaldıkları yerler neresi? Şikayetleri neler? gibi soruların cevabını bulmak ve sayfa içerisinde kullanıcı deneyimini geliştirmek adına ürün yorumlarını toplayabiliriz.
"Samsung Galaxy Note FE" ürünü için Hepsiburada'dan tüm yorumları alabiliriz.
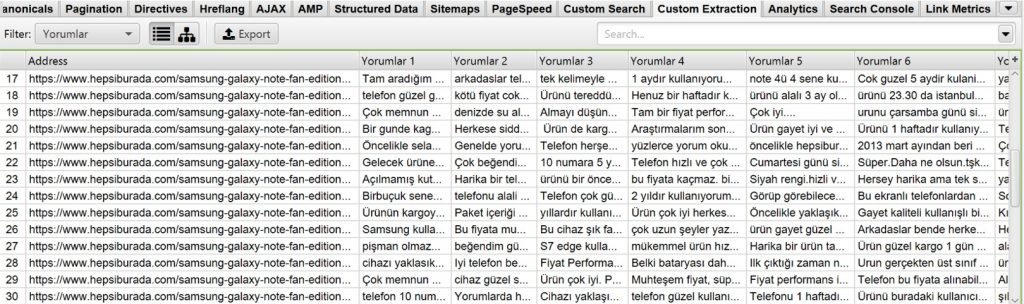
Bu yorumları anlamlandırmak için Excel'de en çok tekrarlanan kelimeleri filtreleyebilir ve anlamlandırabiliriz.
Örnekleri çoğaltabiliriz fakat önemli olan ihtiyaç doğrultusunda hangi verilerin kullanılması gerektiği ve bu veriyi anlamlandırabilmek.
Birden fazla sayfa için ortak özellikleri belirleyip crawl'dan önce araca tanımlayarak crawl sonrası oluşacak verimizi büyütebiliriz.
XPath kullanımına geçelim
XPath kullanımında önce toplayacağımız veri kaynağını inceleyelim. Veri kaynağı ürün fiyatı olabilir, yorum sayısı olabilir, yorumlar olabilir. İhtiyaca göre belirlenebilir.
Ben ürüne ait tüm yorumları almak istiyorum.
Ürün yorumlarını barındıran sayfayı Chrome console ile inceleyebilirim.
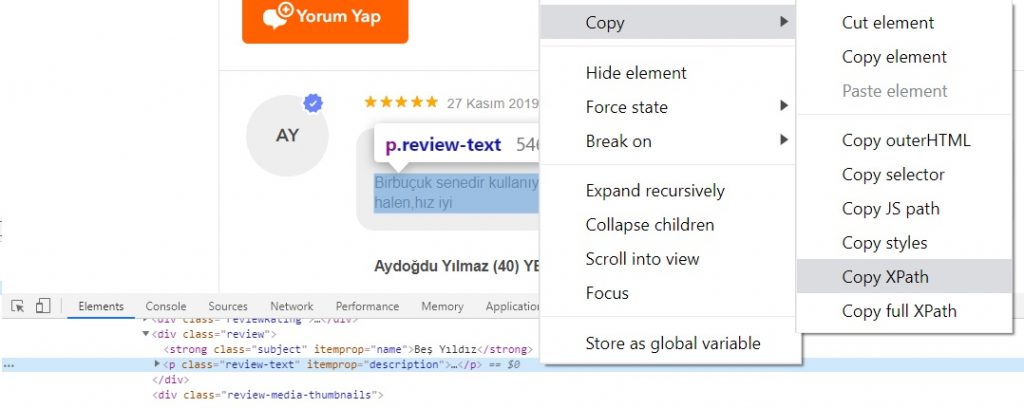
Yorum kısmına baktığımda alanın class'ı "review-text" şeklinde. Bu class'ın XPath değerini almak için Chrome console kullanabiliriz. Chrome console yine de her zaman doğru değeri veremeyebiliyor.
XPath'i bu durumda manuel oluşturmamız gerekebilir. (//*[@class="review-text"] şeklinde)
Veya alternatif olarak Chrome'da Scraper eklentisini kullanabiliriz.
Güncel durum (Ekim 2026): Scraper eklentisi Chrome Web Mağazası'nda artık yayında değil. Screaming Frog'un Custom Extraction penceresindeki tarayıcı simgesi öğeyi sayfada tıklayarak seçmenizi sağlar, XPath ifadesini kendisi önerir.
XPath ile veri toplamayı Screaming Frog üzerinden göstereceğim
Crawl'a başlamadan önce Configuration > Custom > Extraction alanından XPath bilgilerinin doğru şekilde doldurulması gerekiyor.
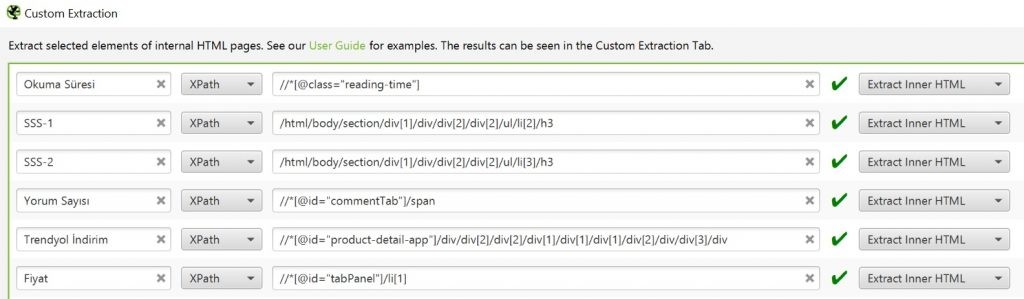
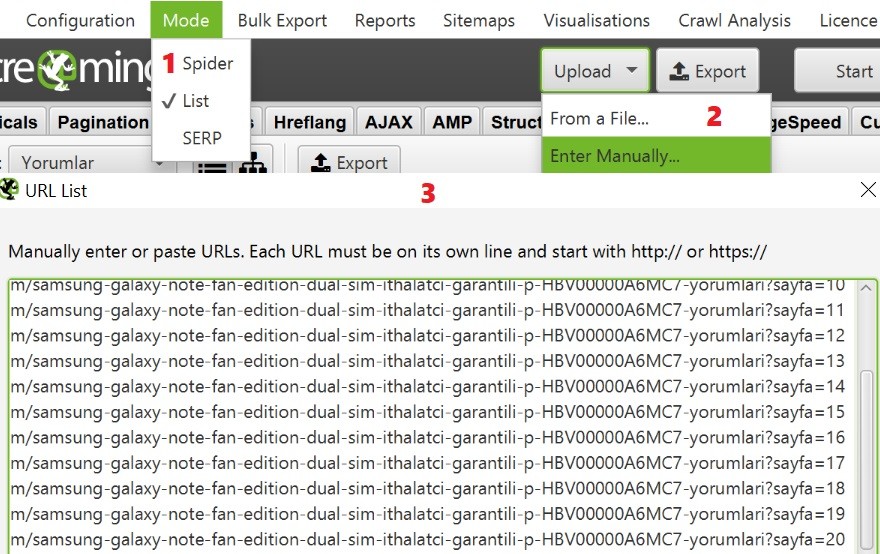
Sonrasında toplayacağım yorumlar sadece 1 ürün için geçerli olduğundan sadece ürün yorumu barındıran sayfaları crawl edeceğim. Taranacak sayfa sayısı fazla ise Excel ile URL'leri çoğaltıp sonrasında Screaming Frog'un liste modunda (Mode > List) sadece belirli sayfaları tarayacağım.
Screaming Frog taramasından site yapısını Gephi ile çizmeyi ayrı bir yazıda anlattım.
Keyifli crawl'lar.
Taha Yelkenci
2010'dan beri SEO. rankZup kurucusu. Sorunuz mu var? Bana yazın →
Sonraki yazı →
Bunlar da ilginizi çekebilir
10 Ağustos 2020 · 3 dk
24 Ocak 2020 · 3 dk
1 Kasım 2018 · 3 dk
Canonicalization Nedir? En İyi Canonical Etiketi Uygulamaları