Crawl Budget (Tarama Bütçesi) Optimizasyonu [Video]
 Taha Yelkenci
Kurucu, SEO ve GEO Danışmanı | · güncelleme: | 3 dk okuma
Tarama bütçesi (crawl budget), Googlebot'un sitenize belirli bir süre içinde yaptığı istek sayısıdır. Daha kaba şekilde Googlebot'un taradığı sayfa sayısı ile sitede geçirdiği süre diyebiliriz. Güncel durum (Ekim 2026): Google tarama bütçesini, Googlebot'un tarayabildiği ve taramak istediği URL kümesi olarak tanımlar.
Crawl bütçesi optimizasyonu ile Googlebot'un önemli içeriklerinizi daha kolay keşfedebilmesini, daha fazla taramasını, harcayacağı zamanı kontrol edebiliriz.
Google belirli zaman aralıklarıyla siteleri tekrar tekrar crawl ediyor. Tarama ile dizine eklemenin nasıl işlediğini rankZup blogundaki crawling ve indexing yazısında anlattık.
Google'dan Gary Illyes, Google'ın crawl'a başlamadan önce siteye ait URL listesi oluşturduğunu belirtiyor. En olumlu sonucu Googlebot'un bu listedeki tüm sayfaları taraması ile alabiliriz.
Googlebot tüm listeyi başından sonuna kadar taramaya başlar. Bu listeyi oluşturması için site içinde fazla link çıkışı alan URL'ler ile sitemapler Googlebot'a yardımcı oluyor. Googlebot listeyi tararken 40x, 50x hataları ile fazla sayıda 30x yönlendirme gibi negatif durumlarla karşılaşabilir. Bu durumlarda Googlebot crawl bütçesini düşürür, daha az sayfa tarayarak siteden ayrılır.
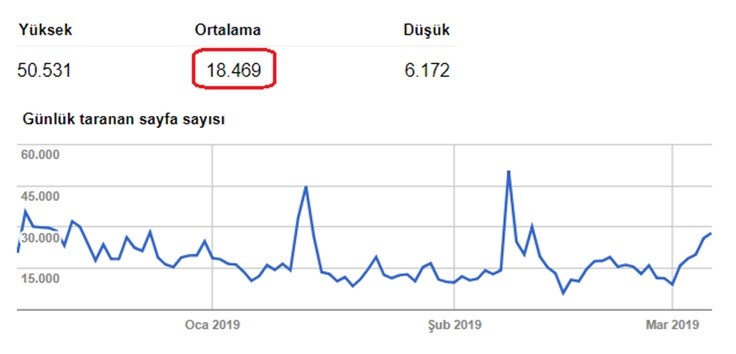
Googlebot'un sitenizde günlük kaç sayfa taradığını, her bir sayfa için ortalama harcadığı zamanı Search Console üzerinde bulabilirsiniz. Güncel durum (Ekim 2026): Bu veriler Search Console'da Ayarlar altındaki Tarama İstatistikleri raporunda toplam tarama istekleri, toplam indirme boyutu, ortalama yanıt süresi adıyla yer alır.
Crawl bütçesini optimize etmek neden önemlidir?
Crawl bütçesini optimize etmek önemlidir, çünkü Googlebot sitemizde her gün yalnızca belirli sayıda sayfayı tarıyor. Sitemize sınırsız bütçe ayırmadığı için tüm sayfalarımızı tarayamadığı zamanlar oluyor. Bütçemiz kısıtlı ise Googlebot'un en önemli sayfaları taramasını sağlamalıyız. Güncel durum (Ekim 2026): Google, tarama bütçesi kılavuzunu haftada bir değişen 1 milyondan fazla sayfası ya da her gün değişen 10 binden fazla sayfası olan siteler için yazdığını belirtir.
Örneğin "Hakkımızda" sayfasını her sayfadan linkliyorsak, sitemap'te ön sıralarda listeliyorsak Googlebot "hakkımızda" sayfasını her gün tarayabilir. Peki "hakkımızda" sayfası organik trafik hedeflediğimiz sayfa mı? Googlebot'un bu sayfayı taramasını, bütçenin ufak da olsa bir kısmını bu sayfada geçirmesini istiyor muyuz? Hayır.
Crawl bütçesini optimize ederken Googlebot'a, trafiği hedeflediğimiz kaliteli içerik sayfalarını öncelikli taratmayı hedeflemeliyiz.
Tarama bütçesini hangi faktörler belirler?
Tarama bütçesini Google'ın kılavuzuna göre iki faktör belirler: tarama kapasitesi sınırı (crawl capacity limit) ve tarama talebi (crawl demand). Google bütçeyi ana makine adı başına hesaplar, yani www.example.com ile code.example.com ayrı bütçeyle taranır.
Tarama kapasitesi sınırı nedir?
Tarama kapasitesi sınırı, Googlebot'un sunucunuzu yormadan açık tutabileceği paralel bağlantıların sayısına ve süresine konan üst sınırdır. Sunucu tutarlı yanıt verdiğinde, gecikme ile ilk bayta kadar geçen süre (TTFB) sabit kaldığında sınır yükselir. Yanıtlar yavaşlarsa ya da sunucu 5xx hataları veya HTTP 429 döndürürse sınır düşer. Kapasite sınırı Google'ın tüm tarayıcı botları arasında paylaşılır, bir botun yüksek talebi öteki botlara kalan kapasiteyi azaltabilir.
Tarama talebi nedir?
Tarama talebi Google'ın sitenizdeki URL'leri ne sıklıkla taramak istediğini gösterir. Kılavuz sizin etkileyebileceğiniz üç faktör sayar.
- Algılanan envanter: siz yön vermezseniz Google bildiği URL'lerin tamamını taramaya çalışır. Kopya, kaldırılmış ya da önemsiz URL'ler tarama süresini boşa harcar.
- Popülerlik: internette daha popüler olan URL'ler daha sık taranır.
- Eskime (staleness): Google değişiklikleri yakalayacak sıklıkta sayfaları yeniden taramak ister.
Google'a göre önemli içeriği sık değişen bir site, büyüklüğünden bağımsız olarak sık taranır. Talep düşükse kapasite sınırına ulaşılmasa bile Google sitenizi daha az tarar.
Tarama bütçesi nasıl artırılır?
Tarama bütçesi Google'ın kılavuzuna göre iki yolla artırılır. Birinci yol sunucu kaynağını artırmaktır, URL Denetleme aracındaki "Ana makine yükü aşıldı" hatası bu ihtiyacı gösterir. İkinci yol içeriğin kalitesini hedeflediğiniz Google ürününe göre yükseltmektir. Google Arama için bu değerlendirmeye popülerlik, genel kullanıcı değeri, içeriğin benzersizliği ile sunum kapasitesi girer. Kopya içerikleri birleştirmek, Googlebot'un benzersiz URL'ler yerine benzersiz içerikleri taramasını sağlar.
Crawl bütçesini nasıl optimize edebiliriz?
Crawl bütçesini aşağıdaki üç çalışmayla optimize edebiliriz.
- Site hızı
- Sitemizdeki gereksiz sayfaları temizleme ve index'e kapatma
- Sunucu analizi
Site Hızı Optimizasyonu
Site hızı optimizasyonu, Googlebot'un bir sayfayı indirmek için harcadığı zamanı azaltarak taradığı sayfa sayısını artırır. Site hızını nasıl iyileştirebileceğimiz konusuna bu başlık altında girmeyeceğim. PageSpeed konusunda yeterince araç ve içerik var.
Daha önce yaşadığım bir tecrübeyi örnek vermek istiyorum. Müşterimin her gün güncellenmesi gereken içerik sayfaları mevcuttu ve bu sayfa sayısı az değil, günde +500 sayfa. Her gün +500 sayfanın başlığını değiştirdiğinizi düşünün. Google arama sonuçlarında dünün indexi gözüktüğünde tıklama oranı düşük oluyordu. Index her gün güncel haliyle yenilendiğinde ise tıklama oranı iki katına çıkıyordu. Bu bizim için çok önemli bir konuydu.
PageSpeed'i nasıl artırırız ve Googlebot'un daha fazla sayfayı taramasını hedefleyelim diyerek çalışmalara başladık. Sayfa yüklenme anında dışarıdan çağrılan, sunucuda bulunan tüm kodları ve dosyaları inceleyip optimize ettik. Bu çalışma bize Googlebot'un "bir sayfayı indirmek için harcanan zaman"ının azalmasını kazandırdı.
Aşağıdaki görsele baktığımızda "bir sayfayı indirmek için harcanan zaman" grafiğinin düşüşte olduğunu görüyoruz. "Günlük taranan sayfa sayısı" grafiğine baktığımızda alttaki grafikle ters orantılı şekilde yükseldiğini görüyoruz.
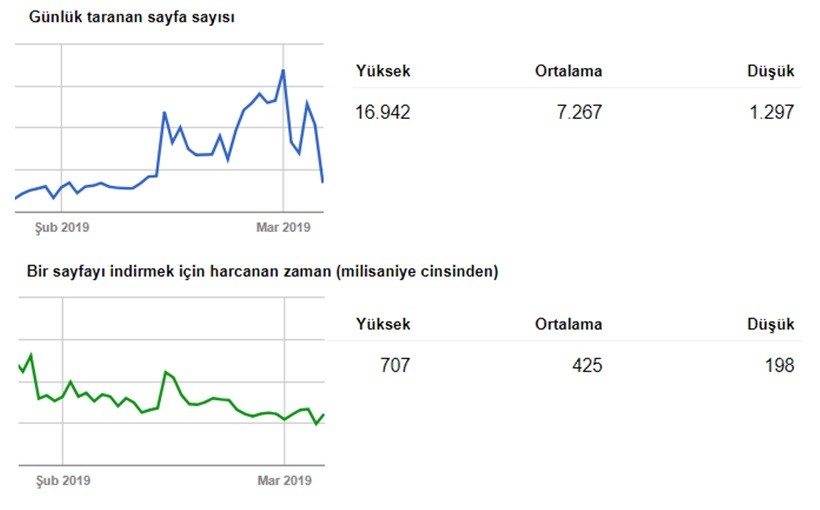
Grafiği özetleyecek olursak: Googlebot'un sayfa başı harcadığı zaman düşerse taradığı sayfa sayısı artıyor.
Sitenizdeki Gereksiz Sayfalardan Kurtulun
Gereksiz sayfalar özellikle e-ticaret sitelerinde crawl bütçesini kötüye kullanır: gereksiz içerik sayfaları, gereksiz parametreler, duplicate algılanacak ürünler. Gereksiz sayfaları en aza indirmek için noindex ve canonical etiketi uygulamalarını kullanmak en sağlıklısı olabilir.
Gereksiz sayfalarınızdan kurtulup Google index'inden kaldırmak istediğinizde tüm bu sayfaları bir dosyada toplayın ve geçici sitemap oluşturun. Sitemap'i Google'a gönderdiğinizde indexlerin kaldırılmasını hızlandırmış olacaksınız. Bunun yanında robots.txt ile de gereksiz sayfaları engelleyebilirsiniz. Son adım olarak geçici sitemap dosyanızı Search Console'dan kaldırabilirsiniz. Güncel durum (Ekim 2026): Google robots.txt ile engellenen sayfayı tarayamadığı için o sayfadaki noindex etiketini göremez, bu yüzden noindex kullandığınız sayfa robots.txt ile engellenmemiş olmalıdır.
Yönlendirmeleri Kontrol Edin
Gereksiz sayfalardan kurtulurken kaldırılan sayfalara yönlendirme eklenebiliyor. Hele ki sitenizin yüz binlerce ürün veya alt sayfası varsa yönlendirilen URL'lerin kontrolü zorlaşabiliyor. Şöyle durumlarla karşılaşabiliyoruz: A sayfası B sayfasına yönleniyor. 1 ay sonra B, C sayfasına yönleniyor. Bu şekilde yönlendirme sayıları arttıkça zincirleme yönlendirmeler de artıyor.
Bu zincirleme yönlendirmeleri en aza indirmeyi deneyebilirsiniz. Örneğin B, C sayfasına yönlendirildiğinde A sayfasını da B'ye uğramadan direkt C sayfasına yönlendirebilirsiniz.
Yönlendirme zincirleri tarama isteği sayısını da artırır. Search Console Tarama İstatistikleri raporu, sunucu taraflı bir zincirde A, B, C adreslerine giden her isteği ayrı bir tarama isteği olarak sayar.
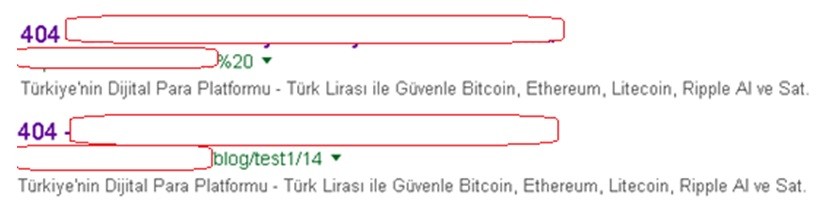
404 Sayfalarda Canonical Etiketi Kullanmayın
404 sayfalarında canonical etiketi kullanımına daha çok içeride yazılım geliştiren firmalarda rastlıyoruz. WordPress veya büyük e-ticaret sistemlerinde karşılaşılmıyor fakat 404 sayfalarında "canonical" etiketi kullanmak bu 404 sayfalarının indexlenmesine yol açabilir. 404 sayfalarında "canonical" etiketi kullanıyorsanız ve "noindex" etiketi kullanmıyorsanız aşağıdaki gibi gereksiz indexler görebilirsiniz.
Filtre ve parametre URL'lerini yönetin
Filtre URL'leri, filtreli gezinmenin (faceted navigation) renk, beden, fiyat gibi seçimlerle ürettiği parametreli adreslerdir. Google'ın filtreli gezinme kılavuzuna göre tarayıcı bir filtre URL'sinin işe yaramadığını ancak taradıktan sonra anlar, boşa giden bu tarama yeni sayfaların keşfini yavaşlatır.
Filtre sayfalarının dizinde görünmesi gerekmiyorsa Google bu adresleri robots.txt dosyasında disallow kuralıyla engellemeyi önerir. Filtre sayfaları dizinde kalacaksa parametreleri & ile ayırın, filtre sırasını sabit tutun, sonuç vermeyen kombinasyonda 404 döndürün. Tarama bütçesi için noindex kullanmayın, çünkü Googlebot kuralı görmek için sayfayı yine indirir.
Sunucu hatalarını ve durum kodlarını izleyin
Sunucu hatalarını izlemek gerekir, çünkü 5xx yanıtları ile bağlantı zaman aşımları Google'ın taramayı yavaşlatmasına yol açar. Google'ın tarama ile ilgili gerçekler sayfasına göre 4xx kodu döndüren sayfalar (429 hariç) bütçeyi boşa harcamaz. Kalıcı olarak kaldırılan sayfalarda, örneğin satışı durdurulan ürünlerde, 404 ya da 410 döndürün, çünkü 404 kodu o URL'nin yeniden taranmaması için güçlü bir sinyaldir. Soft 404 sayfaları taranmaya devam eder, bütçeyi tüketir.
Crawl Bütçenizi Analiz Edin
Crawl bütçenizi optimize ettiniz, peki nasıl ölçeceksiniz? Crawl bütçesi analizi sunucu log kayıtlarıyla yapılır, şu üç sorunun cevabını arar.
- Googlebot sayfaya ne sıklıkla geliyor
- En çok hangi sayfayı tarıyor
- X sayfasını tararken ne kadar veri indiriyor
Bu üç soruyu cevaplayabilmek için sunucunun günlük (log) verilerini analiz etmeniz gerekiyor. Excel'de tablolar oluşturarak anlamlandırabilirsiniz fakat önerim araç kullanmak olacaktır.
Analiz için Splunk, Logentries veya Stackify araçlarını kullanabilirsiniz. Güncel durum (Ekim 2026): Logentries'in adresi (logentries.com) artık Rapid7 sitesine yönleniyor, Splunk ile Stackify siteleri yayında.
Log analizi kısmı başlı başına bir konu. Sadece bu konu için bir içerik üretilebilir. Talep olursa üretebilirim. Güncel durum (Ekim 2026): o yazıyı yazdım, SEO için log analizi yazımda okuyabilirsiniz.
Google sızıntısı sayfanın değişim geçmişi hakkında ne gösteriyor?
Google sızıntısı bir sayfanın değişim geçmişini tutan alanları gösteriyor. Sızan Content Warehouse dokümanında CrawlerChangerateUrlChangerate adında bir modül var, açıklamaya göre modül bir belgenin değişim hızı bilgisini taşır. İlgili urlHistory alanı belgenin en çok son 20 değişikliğini saklar. Dört alanın açıklaması doğrudan kendi verilerinizle karşılaştırılabilir:
- lastFetched: Google'ın belgenin taranmış bir kopyasını en son gördüğü zaman. Bu değeri sunucu log kayıtlarındaki son Googlebot isteğiyle karşılaştırın.
- lastChanged: Google'ın belgenin değişmiş bir kopyasını en son gördüğü zaman. Bu değeri ana içeriği en son değiştirdiğiniz tarihle karşılaştırın.
- lastChangeSignificance: son değişikliğin 0 ile 1 arasındaki önemi, içerik değişiklikleri bu değeri etkiler. Açıklamaya göre değer taramayı önceliklendirmede kullanılabilir.
- isImsNotModified (CrawlerChangerateUrlVersion modülü): taramanın 304 Not Modified yanıtı alıp almadığı, sunucu log kayıtlarınız bu yanıtları gösterir.
Önemli her URL için bu tarihleri yan yana koyun. Ana içeriği değiştiği halde o günden beri Googlebot isteği almayan sayfada site haritasındaki lastmod değerini ve sayfaya giden iç linkleri kontrol edin. Google'ın tarama bütçesi kılavuzu, güncellenen içerik için <lastmod> etiketini, son taramadan beri değişmeyen sayfa için 304 yanıtını önerir. Sayfalarınızdaki tarih sinyallerini karşılaştırma yöntemini sızıntı denetimi yazımda anlattım. Sızan doküman bu alanların var olduğunu gösterir, tarama planındaki ağırlıkları ile canlıda nasıl kullanıldıkları bilinmiyor.
Taha Yelkenci
2010'dan beri SEO. rankZup kurucusu. Sorunuz mu var? Bana yazın →
Yorumlar
İlk yorumu siz yazın
← Önceki yazı
Sonraki yazı →
Bunlar da ilginizi çekebilir
10 Ağustos 2020 · 3 dk
6 Aralık 2019 · 3 dk
24 Ekim 2019 · 3 dk
SEO Çalışmalarında En Çok Yapılan Hatalar ve Çözümleri [Video]